Détecteur de Doublons
Autres langues : EnglishEspañolDeutsch日本語한국어PortuguêsРусский中文
Le détecteur de doublons est une application open-source pour détecter du texte similaire dans un ou plusieurs fichiers. Il peut être utilisé pour trouver des doublons à 100% ainsi que du contenu similaire mais pas identique. L'outil est compatible avec plusieurs formats, notamment le texte brut, Markdown et XML.
L'outil de détection de doublons peut vous aider avec :
- Détection de plagiat
- Gestion de contenu
- Optimisation SEO
- Déduplication de données
Exemple de contenu en double
Voici un exemple rapide pour vous donner une idée de ce que l'outil détecte :
Comment utiliser
- Téléchargez l'application. Alternativement, vous pouvez le compiler vous-même à partir de les sources.
Exécutez
./gradlew fatJaravec JDK 21 dans le répertoire des sources. Le JAR sera dansbuild/libs/duplicate-finder.jar. - Assurez-vous que Java 21 ou une version ultérieure est installée sur votre ordinateur
- Dans le terminal, ouvrez le dossier contenant le fichier .jar que vous avez téléchargé
-
Exécutez
java -jar duplicate-finder.jaravec les paramètres suivants :Paramètre Signification Exemple -r/--rootChemin relatif ou absolu vers le dossier où vous souhaitez rechercher du contenu en double. Par défaut : le répertoire de travail actuel. -r=./my-project/-o/--outputChemin relatif ou absolu vers le dossier où vous souhaitez enregistrer les résultats de l’analyse. Par défaut : ./duplicate_finder_output, relatif au répertoire de travail actuel. -o=./my-project/duplicates/-f/--fileMaskFichiers : Indiquez les extensions des fichiers à analyser, séparées par des virgules, sans le point initial. Utilisez * pour inclure toutes les extensions.
Parseur : Chaque entrée peut être une extension seule ou extension:parser. Le parseur détermine comment découper un fichier en fragments de texte à comparer. S’il est omis, il est choisi selon l’extension ; les extensions inconnues utilisent file.
Valeurs par défaut : La liste d’extensions par défaut est .md, .mdx, .xml, .adoc, .asciidoc et .properties. Spécifier -f remplace cette liste.
Noms des parseurs (après les deux-points) et fragments de texte qu’ils produisent :
- md – un élément markdown
- line – une seule ligne de texte
- xml – un élément XML
- adoc – élément AsciiDoc
- file – le contenu du fichier entier
- properties – la valeur d’une propriété
-f=md,mdx
Analyser uniquement les fichiers .md et .mdx, avec le parseur Markdown pour les deux.-f=topic:xml,txt:line
Analyser les fichiers .topic par éléments XML et les fichiers .txt ligne par ligne.-f="*:line"
Analyser tous les fichiers, en traitant chaque ligne comme un fragment de texte distinct.-l/--minLengthLa longueur minimale (en caractères) pour qu'un fragment de texte soit analysé. Par défaut : 100 (les fragments de texte de moins de 100 caractères sont ignorés) -l=150-s/--minSimilarityLe degré minimum de similarité entre deux fragments de texte pour être considérés comme des doublons. Par défaut : 0.9 (90%) -s=0.85-d/--minDuplicatesLe nombre minimum de doublons pour qu'un groupe de doublons soit signalé. Par défaut : 1 (un doublon suffit) -d=5-ui/--uiUtiliser ou non l'interface interactive. Options : - none – pas d'interface, écriture dans les fichiers uniquement
- swing – ancienne interface
- compose – nouvelle interface, par défaut
-ui=none-v/--verboseAfficher les durées d’indexation et d’analyse dans la console. Désactivé par défaut. Les erreurs des fichiers ignorés sont signalées indépendamment de cette option. -v-g/--gram(avancé) longueur du n-gramme – affecte la vitesse, l'empreinte mémoire et la précision de l'analyse. La différence dépend des spécificités du contenu. -g=10-w/--keepWhitespaceConserver les occurrences de plusieurs espaces consécutifs dans le contenu analysé. Par défaut, les espaces sont normalisés, ce qui signifie que plusieurs caractères d'espacement consécutifs sont traités et affichés comme un seul. -w-i/--inlineInclure le contenu des éléments imbriqués dans leur élément englobant. Par exemple :
<parent>Some content including <child>nested content</child></parent>Avec cette option, l'élément externe sera analysé comme 'Some content including nested content', alors que par défaut il est analysé comme 'Some content including </>'.
-i
Fichier de configuration
Vous pouvez enregistrer les paramètres dans duplicate-finder.properties à la racine du contenu (-r ou le répertoire actuel). Utilisez les noms longs des options sans -- comme clés. Par exemple :
fileMask=topic:xml,md,mdx
minSimilarity=0.85
minLength=200
ui=none
Exécutez sans arguments pour charger le fichier du répertoire actuel, ou utilisez -r pour choisir une autre racine de contenu. Les paramètres absents utilisent leurs valeurs par défaut. Les options -o, -ui et -v peuvent remplacer les paramètres enregistrés. Passer -s, -l, -d, -f, -g, -w ou -i ignore entièrement le fichier de configuration.
Exemple de commande
Voici un exemple de ce à quoi votre commande pourrait ressembler :
java -jar duplicate-finder.jar -r=/Users/me.user/my-site -f=md,mdx -s=0.85 -d=5 -l=200
La commande ci-dessus effectuera les actions suivantes :
-
-r=/Users/me.user/my-site– rechercher du contenu similaire dans '/Users/me.user/my-site' et ses sous-répertoires -
-f=md,mdx– ne considérer que les fichiers avec les extensions '.md' et '.mdx' et les analyser selon les règles Markdown -
-s=0.85– signaler uniquement les correspondances avec une similarité de 85% ou plus -
-d=5– signaler uniquement les textes dupliqués 5 fois ou plus -
-l=200– signaler uniquement les textes de 200 caractères ou plus
Résultats
Selon les paramètres et la taille du projet, vous devrez peut-être attendre un peu que l'analyse se termine. Ensuite, les résultats s'ouvriront dans le visualiseur de doublons et seront enregistrés dans le dossier défini par l'option '-o'. Par défaut, les rapports texte sont enregistrés dans ./duplicate_finder_output, dans le répertoire de travail. Utilisez -ui=none pour enregistrer les rapports sans ouvrir le visualiseur.
Voici ce que vous verrez dans le visualiseur de doublons :
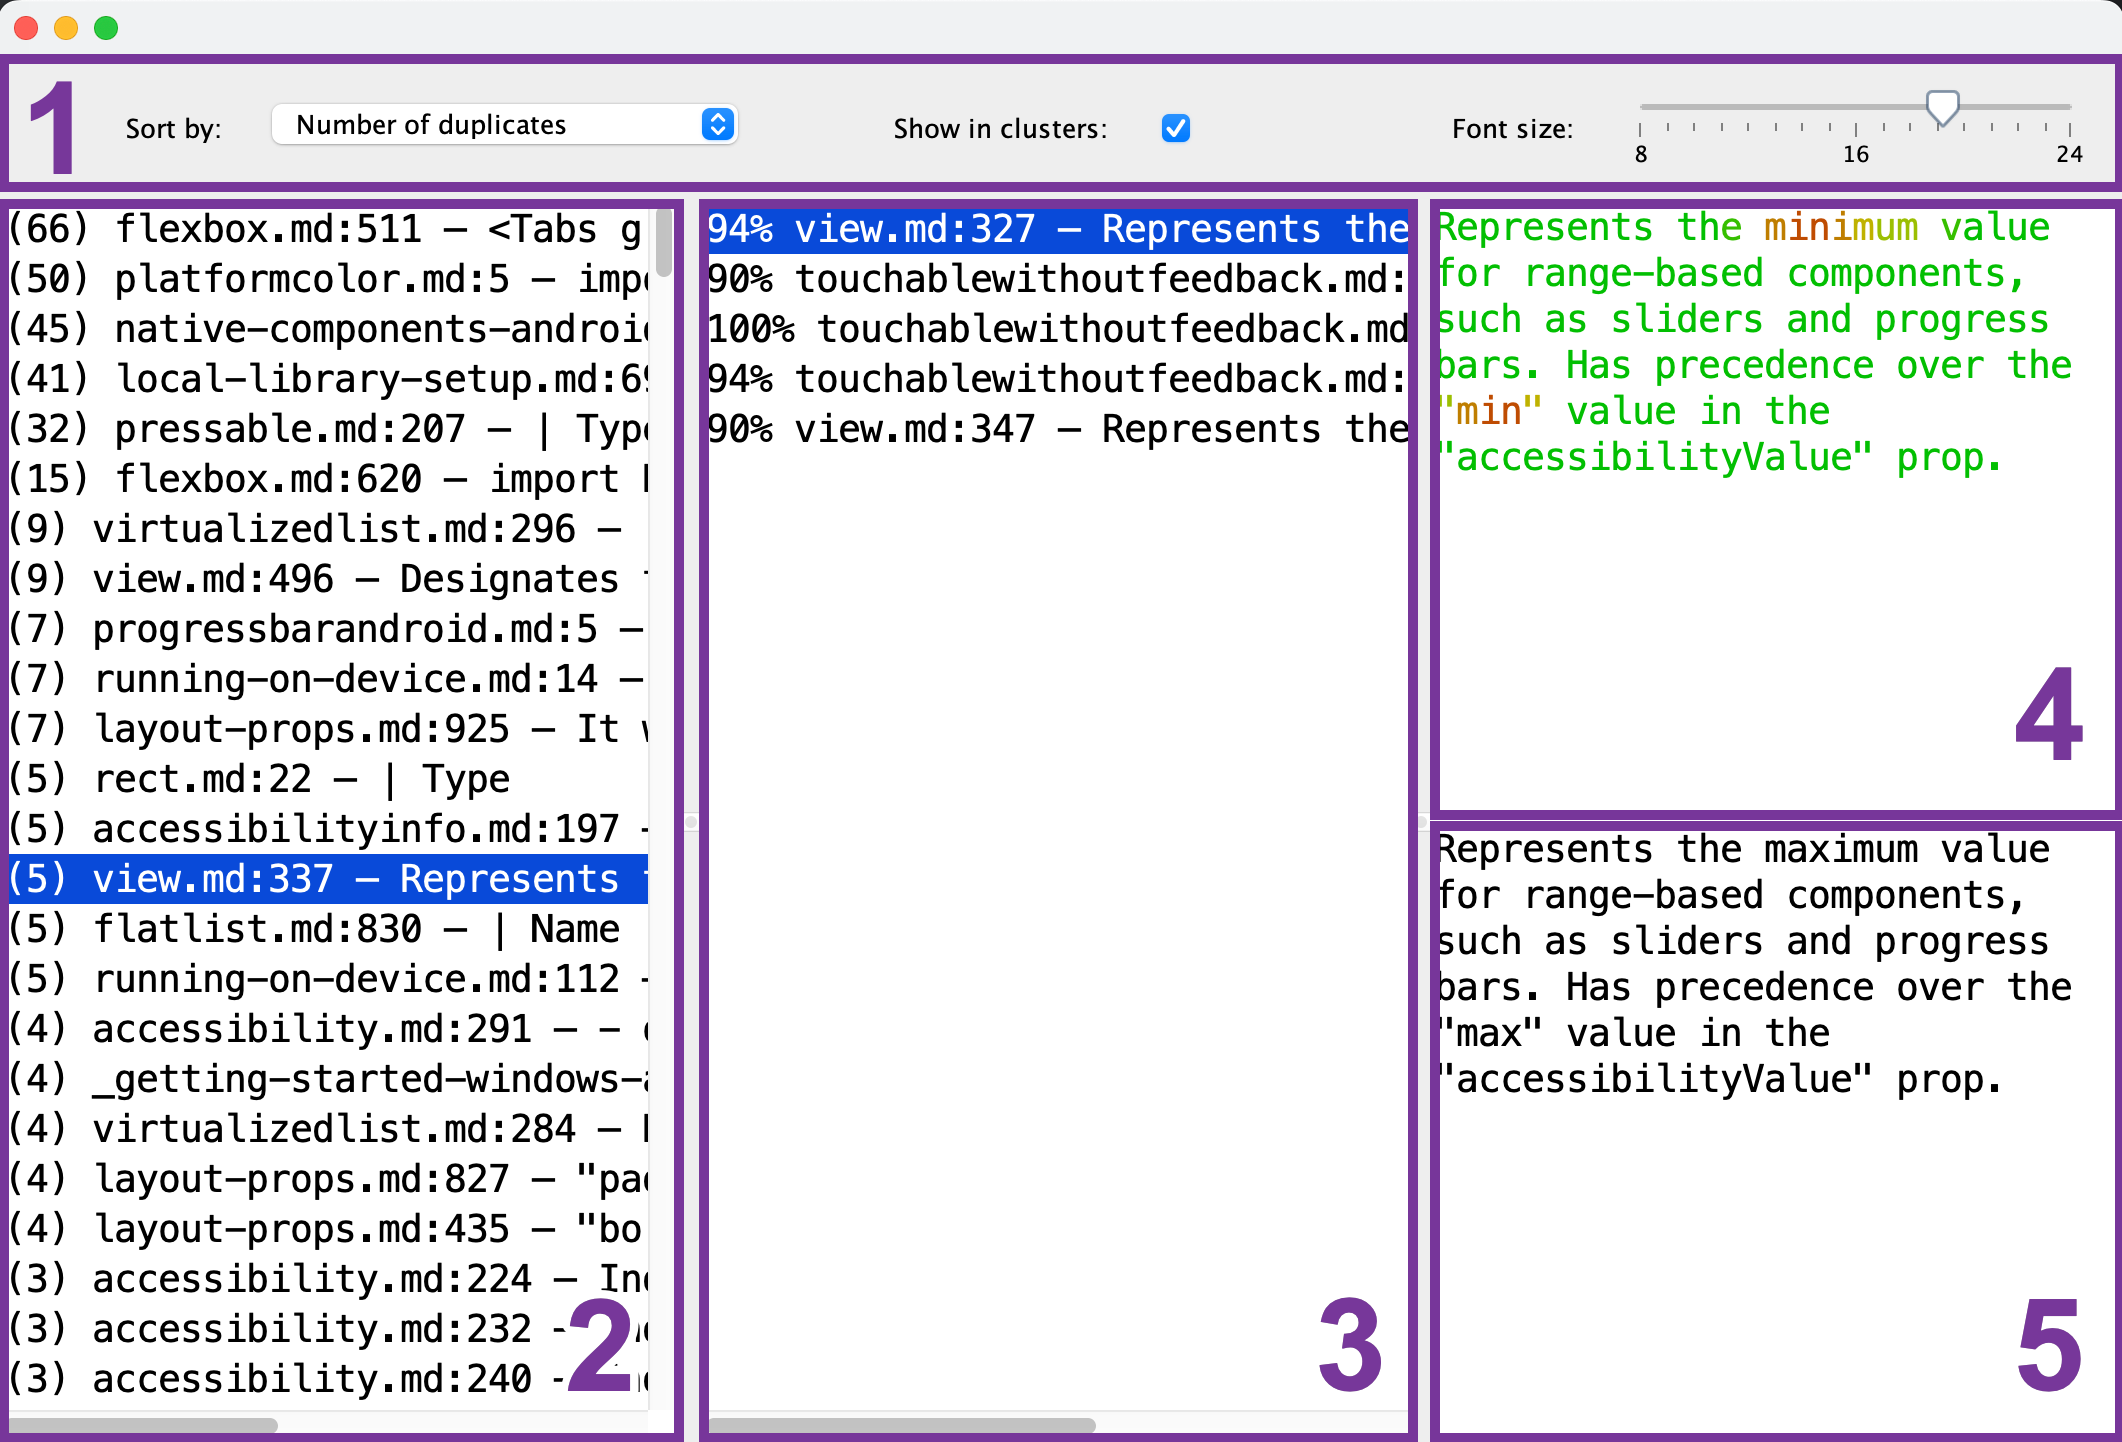
- Barre d'outils : configurez la taille de police, l'ordre de tri et si vous souhaitez voir un seul fragment de référence (2) pour chaque groupe de doublons. Utilisez Fuzzy search pour saisir une requête textuelle et trouver des passages similaires avec un seuil de similarité réglable.
- Liste des fragments de référence : sélectionnez le fragment qui sert de référence pour la comparaison.
- Liste des fragments en double : après avoir sélectionné le fragment de référence (2), cette liste affichera les fragments similaires. Pour prévisualiser un doublon, sélectionnez-le dans la liste.
- Aperçu du fragment de référence : après avoir sélectionné le fragment de référence (2), vous pouvez prévisualiser son contenu ici. Les parties communes sont affichées en vert, tandis que les parties différentes sont affichées en rouge. Plus les fragments en double (3) ont des parties communes, plus ils apparaîtront en vert.
- Aperçu du fragment en double : après avoir sélectionné le fragment en double (3), son aperçu apparaîtra ici. Vous pouvez l'utiliser pour une comparaison rapide avec le fragment de référence sélectionné (4).
En savoir plus et contact
Si vous êtes intéressé par le développement de cet outil, consultez la série d'articles de blog associée :
- Detecteur de Doublons pour Texte
- Detecteur de Doublons pour Texte : Exigences
- Junie Code (Support AsciiDoc)
- Detecteur de Doublons pour Texte : Algorithme
Pour vos commentaires, vous pouvez me contacter en utilisant les coordonnées en bas de cette page. Je serai heureux d'entendre vos avis et demandes de fonctionnalités.
Licence
Le code est sous licence MIT, ce qui signifie que vous êtes libre de l'utiliser à n'importe quelle fin, ainsi que de le forker et de le modifier.


