查找重复项
阅读其他语言: EnglishEspañolFrançaisDeutsch日本語한국어PortuguêsРусский
重复查找器是一款开源应用程序,用于检测一个或多个文件中的相似文本。 它可以用于查找100%的重复内容以及相似但不相同的内容。 该工具兼容包括纯文本、Markdown 和 XML 在内的几种格式。
重复查找工具可以帮助您:
- 检测抄袭
- 内容管理
- SEO优化
- 数据去重
重复内容示例
这是一个快速示例,可以让你了解该工具检测的内容:
如何使用
- 下载应用程序。 或者,您可以自己从源码.
运行
./gradlew fatJar(在源码目录中使用 JDK 21)。生成的 JAR 位于build/libs/duplicate-finder.jar. - 确保您的计算机上安装了 Java 21 或更高版本
- 在终端中,打开下载的 .jar 文件所在的文件夹
-
执行
java -jar duplicate-finder.jar并使用以下参数:参数 意义 例子 -r/--root要搜索重复内容的文件夹的相对或绝对路径。默认值:当前工作目录。 -r=./my-project/-o/--output保存分析结果的文件夹的相对或绝对路径。默认值:./duplicate_finder_output,相对于当前工作目录。 -o=./my-project/duplicates/-f/--fileMask文件: 列出要扫描的文件扩展名,用逗号分隔,不包含开头的点。使用 * 包含所有扩展名。
解析器: 每项可以只写扩展名,也可以写成 extension:parser。解析器决定如何将文件拆分为用于比较的文本块。省略解析器时,会根据扩展名选择;未知扩展名使用 file。
默认值: 默认扩展名列表为 .md、.mdx、.xml、.adoc、.asciidoc 和 .properties。指定 -f 会替换此列表。
解析器名称(冒号后面的部分)及其生成的文本块:
- md – 一个markdown元素
- line – 单行文本
- xml – 一个XML元素
- adoc – AsciiDoc 元素
- file – 整个文件的内容
- properties – 属性值
-f=md,mdx
只扫描 .md 和 .mdx 文件,两者都使用 Markdown 解析器。-f=topic:xml,txt:line
将 .topic 文件按 XML 元素拆分,将 .txt 文件按行拆分。-f="*:line"
扫描所有文件,将每一行作为独立的文本块。-l/--minLength要分析的文本块的最小长度(以字符计)。 默认值:100(短于 100 个字符的文本片段将被忽略) -l=150-s/--minSimilarity两个文本块被视为重复的最低相似度。 默认值: 0.9 (90%) -s=0.85-d/--minDuplicates报告重复组的最低重复次数。默认值:1(一个重复项就够了) -d=5-ui/--ui是否使用交互式用户界面。选项: - none – 无界面,仅写入文件
- swing – 旧界面
- compose – 新界面,默认
-ui=none-v/--verbose在控制台输出索引和分析耗时。默认禁用。无论是否启用此选项,都会报告被跳过文件的错误。 -v-g/--gram(高级)ngram 长度 – 影响速度、内存占用以及分析的准确性。差异取决于内容的具体情况。 -g=10-w/--keepWhitespace在解析的内容中保留多个连续空格的出现。默认情况下,空格会被标准化,这意味着多个连续的空格字符会被视为一个并显示为一个。 -w-i/--inline是否在其封闭元素中包含嵌套元素的内容。例如:
<parent>Some content including <child>nested content</child></parent>启用此选项后,外部元素将解析为'Some content including nested content', 而默认情况下,它解析为'Some content including </>'。
-i
配置文件
可以将设置保存在内容根目录(-r 指定的目录或当前目录)中的 duplicate-finder.properties 文件内。以不带 -- 的长选项名作为键。例如:
fileMask=topic:xml,md,mdx
minSimilarity=0.85
minLength=200
ui=none
不带参数运行时,会从当前目录加载该文件;也可以用 -r 指定其他内容根目录。未指定的设置使用默认值。-o、-ui 和 -v 可以覆盖已保存的设置。传入 -s、-l、-d、-f、-g、-w 或 -i 会完全忽略配置文件。
命令示例
以下是您的命令可能的样子:
java -jar duplicate-finder.jar -r=/Users/me.user/my-site -f=md,mdx -s=0.85 -d=5 -l=200
上述命令将执行以下操作:
-
-r=/Users/me.user/my-site– 在 '/Users/me.user/my-site' 及其子目录中搜索类似内容 -
-f=md,mdx– 仅考虑扩展名为 '.md' 和 '.mdx' 的文件,并根据 Markdown 规则进行解析 -
-s=0.85– 仅报告相似度为 85% 或更高的匹配项 -
-d=5– 仅报告被重复 5 次或更多次的文本 -
-l=200– 仅报告 200 个字符或更长的文本
结果
根据设置和项目规模,您可能需要稍等片刻以完成分析。 之后,结果将会在重复项查看器中打开,并保存在用“-o”命令行选项定义的文件夹中。 默认情况下,文本报告保存在工作目录下的 ./duplicate_finder_output 中。使用 -ui=none 可以保存报告而不打开查看器。
以下是您在重复查看器中看到的:
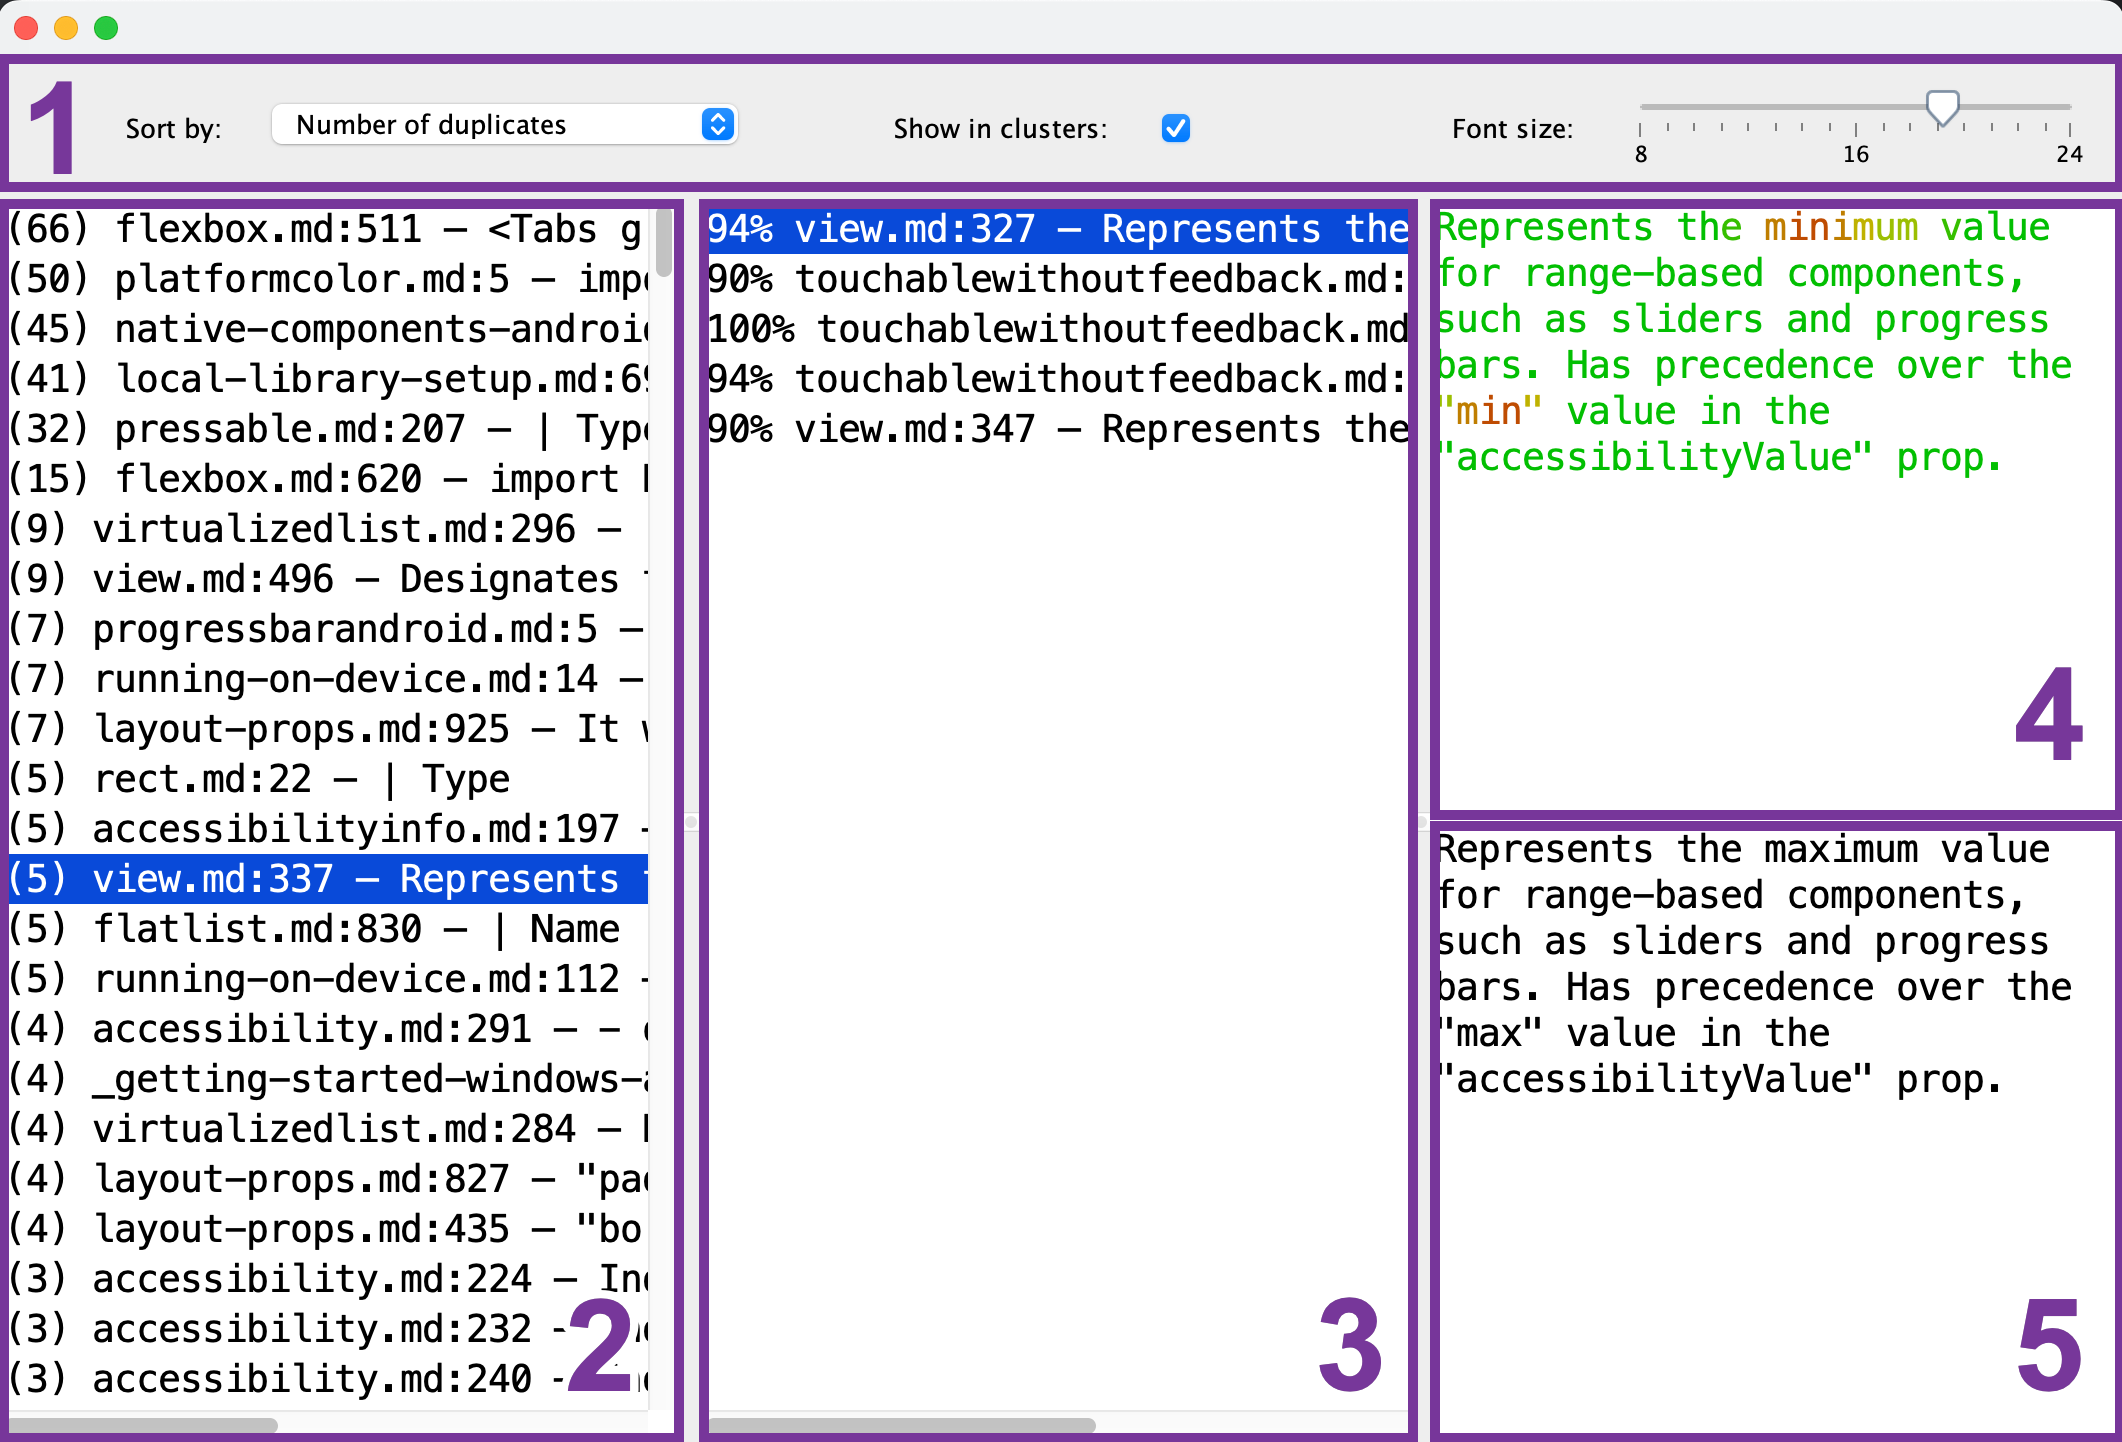
- 工具栏:配置字体大小、排序顺序,以及是否只想看到每个重复组的单个参考块(2)。 使用 Fuzzy search 输入文本查询,并通过可调节的相似度阈值查找相似段落。
- 参考块列表:选择作为比较参考的块。
- 重复块列表:在选择参考块(2)后,此列表将显示与其相似的块。要预览重复项,请从列表中选择它。
- 参考块预览:选择参考块(2)后,可以在此处预览其内容。常见部分以绿色显示,不同部分以红色显示。重复块(3)中具有共同部分的数量越多,显示的绿色就越多。
- 重复块预览:选择重复块后,其预览将出现在此处。您可以使用它与选定的参考块(4)进行快速比较。
了解更多及联系我们
如果您对该工具的开发感兴趣,请查看相关的博客系列文章:
如有反馈意见,可以使用本页底部的联系方式与我联系。我很乐意听取您的意见和功能请求。
许可
代码在 MIT 许可证下许可,这意味着您可以自由使用它用于任何目的,以及分叉和修改它。


