중복 찾기
다른 언어: EnglishEspañolFrançaisDeutsch日本語PortuguêsРусский中文
중복 찾기는 하나 이상의 파일에서 유사한 텍스트를 감지하기 위한 오픈 소스 애플리케이션입니다. 100% 중복과 유사하지만 동일하지 않은 콘텐츠를 찾는 데 사용할 수 있습니다. 이 도구는 일반 텍스트, Markdown, XML을 포함한 여러 형식과 호환됩니다.
중복 찾기 도구는 다음을 도와줍니다:
- 표절 감지
- 콘텐츠 관리
- SEO 최적화
- 데이터 중복 제거
중복 콘텐츠 예
도구가 감지하는 것에 대한 아이디어를 얻을 수 있는 빠른 예입니다:
사용 방법
- 앱을 다운로드하세요. 또는 직접 빌드할 수 있습니다 소스.
실행:
./gradlew fatJar(소스 디렉토리에서 JDK 21 사용). 생성된 JAR 위치:build/libs/duplicate-finder.jar. - 컴퓨터에 Java 21 이상이 설치되어 있는지 확인하세요
- 터미널에서 다운로드한 .jar 파일이 있는 폴더를 엽니다
-
실행
java -jar duplicate-finder.jar다음 매개변수와 함께:매개변수 의미 예 -r/--root중복 콘텐츠를 검색하려는 폴더의 상대 경로 또는 절대 경로입니다. 기본값: 현재 작업 디렉토리. -r=./my-project/-o/--output분석 결과를 저장하고자 하는 폴더의 상대 또는 절대 경로입니다. 기본값: 현재 작업 디렉토리를 기준으로 ./duplicate_finder_output. -o=./my-project/duplicates/-f/--fileMask파일: 검색할 파일 확장자를 앞의 점 없이 쉼표로 구분해 나열합니다. 모든 확장자를 포함하려면 *를 사용하세요.
파서: 각 항목은 확장자만 쓰거나 extension:parser 형식으로 지정할 수 있습니다. 파서는 파일을 비교할 텍스트 조각으로 나누는 방법을 결정합니다. 생략하면 확장자에 따라 선택되며, 알 수 없는 확장자에는 file을 사용합니다.
기본값: 기본 확장자 목록은 .md, .mdx, .xml, .adoc, .asciidoc, .properties입니다. -f를 지정하면 이 목록을 대체합니다.
파서 이름(콜론 뒤에 지정)과 생성하는 텍스트 조각:
- md – 마크다운 요소
- line – 한 줄의 텍스트
- xml – XML 요소
- adoc – AsciiDoc 요소
- file – 전체 파일의 내용
- properties – 속성 값
-f=md,mdx
.md 및 .mdx 파일만 검색하며, 둘 다 Markdown 파서를 사용합니다.-f=topic:xml,txt:line
.topic 파일은 XML 요소로, .txt 파일은 한 줄씩 나누어 검색합니다.-f="*:line"
모든 파일을 검색하며, 각 줄을 별도의 텍스트 조각으로 취급합니다.-l/--minLength분석할 텍스트 조각의 최소 길이(문자 수). 기본값: 100 (100자보다 짧은 텍스트 조각은 무시됨) -l=150-s/--minSimilarity두 텍스트 조각이 중복으로 간주될 최소 유사도. 기본값: 0.9 (90%) -s=0.85-d/--minDuplicates중복 그룹이 보고될 최소 중복 수입니다. 기본값: 1 (중복이 하나라도 있으면 됨) -d=5-ui/--ui대화형 UI를 사용할지 여부를 결정합니다. 옵션: - none – UI 없음, 파일에만 기록
- swing – 구형 UI
- compose – 새 UI, 기본값
-ui=none-v/--verbose인덱싱 및 분석 시간을 콘솔에 출력합니다. 기본적으로 비활성화됩니다. 건너뛴 파일의 오류는 이 옵션과 관계없이 표시됩니다. -v-g/--gram고급 ngram 길이 – 속도, 메모리 사용량 및 분석 정확도에 영향을 줍니다. 차이는 콘텐츠의 특정 사항에 따라 다릅니다. -g=10-w/--keepWhitespace파싱된 내용에서 연속적인 공백을 유지합니다. 기본적으로 공백은 정규화되며, 연속적인 여러 공백 문자는 하나로 처리되고 하나로 표시됩니다. -w-i/--inline중첩된 요소의 내용을 둘러싸는 요소에 포함할지 여부. 예:
<parent>Some content including <child>nested content</child></parent>이 옵션을 활성화하면 외부 요소가 'Some content including nested content'으로 구문 분석되며, 기본적으로는 'Some content including </>'으로 구문 분석됩니다.
-i
설정 파일
콘텐츠 루트(-r로 지정한 디렉토리 또는 현재 디렉토리)의 duplicate-finder.properties에 설정을 저장할 수 있습니다. --를 제외한 긴 옵션 이름을 키로 사용하세요. 예:
fileMask=topic:xml,md,mdx
minSimilarity=0.85
minLength=200
ui=none
인수 없이 실행하면 현재 디렉토리에서 파일을 불러옵니다. 다른 콘텐츠 루트를 선택하려면 -r을 사용하세요. 누락된 설정은 기본값을 사용합니다. -o, -ui, -v 옵션으로 저장된 설정을 바꿀 수 있습니다. -s, -l, -d, -f, -g, -w 또는 -i를 전달하면 설정 파일 전체를 무시합니다.
명령어 예제
여기 당신의 명령어가 어떻게 보일지에 대한 예시가 있습니다:
java -jar duplicate-finder.jar -r=/Users/me.user/my-site -f=md,mdx -s=0.85 -d=5 -l=200
위 명령어는 다음을 수행합니다:
-
-r=/Users/me.user/my-site– '/Users/me.user/my-site' 및 하위 디렉토리에서 유사한 콘텐츠 검색 -
-f=md,mdx– '.md' 및 '.mdx' 확장자를 가진 파일만 고려하고 Markdown 규칙에 따라 파싱 -
-s=0.85– 유사도가 85% 이상인 항목만 보고 -
-d=5– 5회 이상 중복된 텍스트만 보고 -
-l=200– 200자 이상인 텍스트만 보고
결과
설정과 프로젝트의 크기에 따라 분석이 완료되는 데 잠시 기다려야 할 수도 있습니다. 그 후 결과는 중복 뷰어에서 열리고 '-o' 명령줄 옵션으로 정의된 폴더에 저장됩니다. 기본적으로 텍스트 보고서는 작업 디렉토리의 ./duplicate_finder_output에 저장됩니다. 뷰어를 열지 않고 보고서만 저장하려면 -ui=none을 사용하세요.
이것이 중복 뷰어에서 보는 내용입니다:
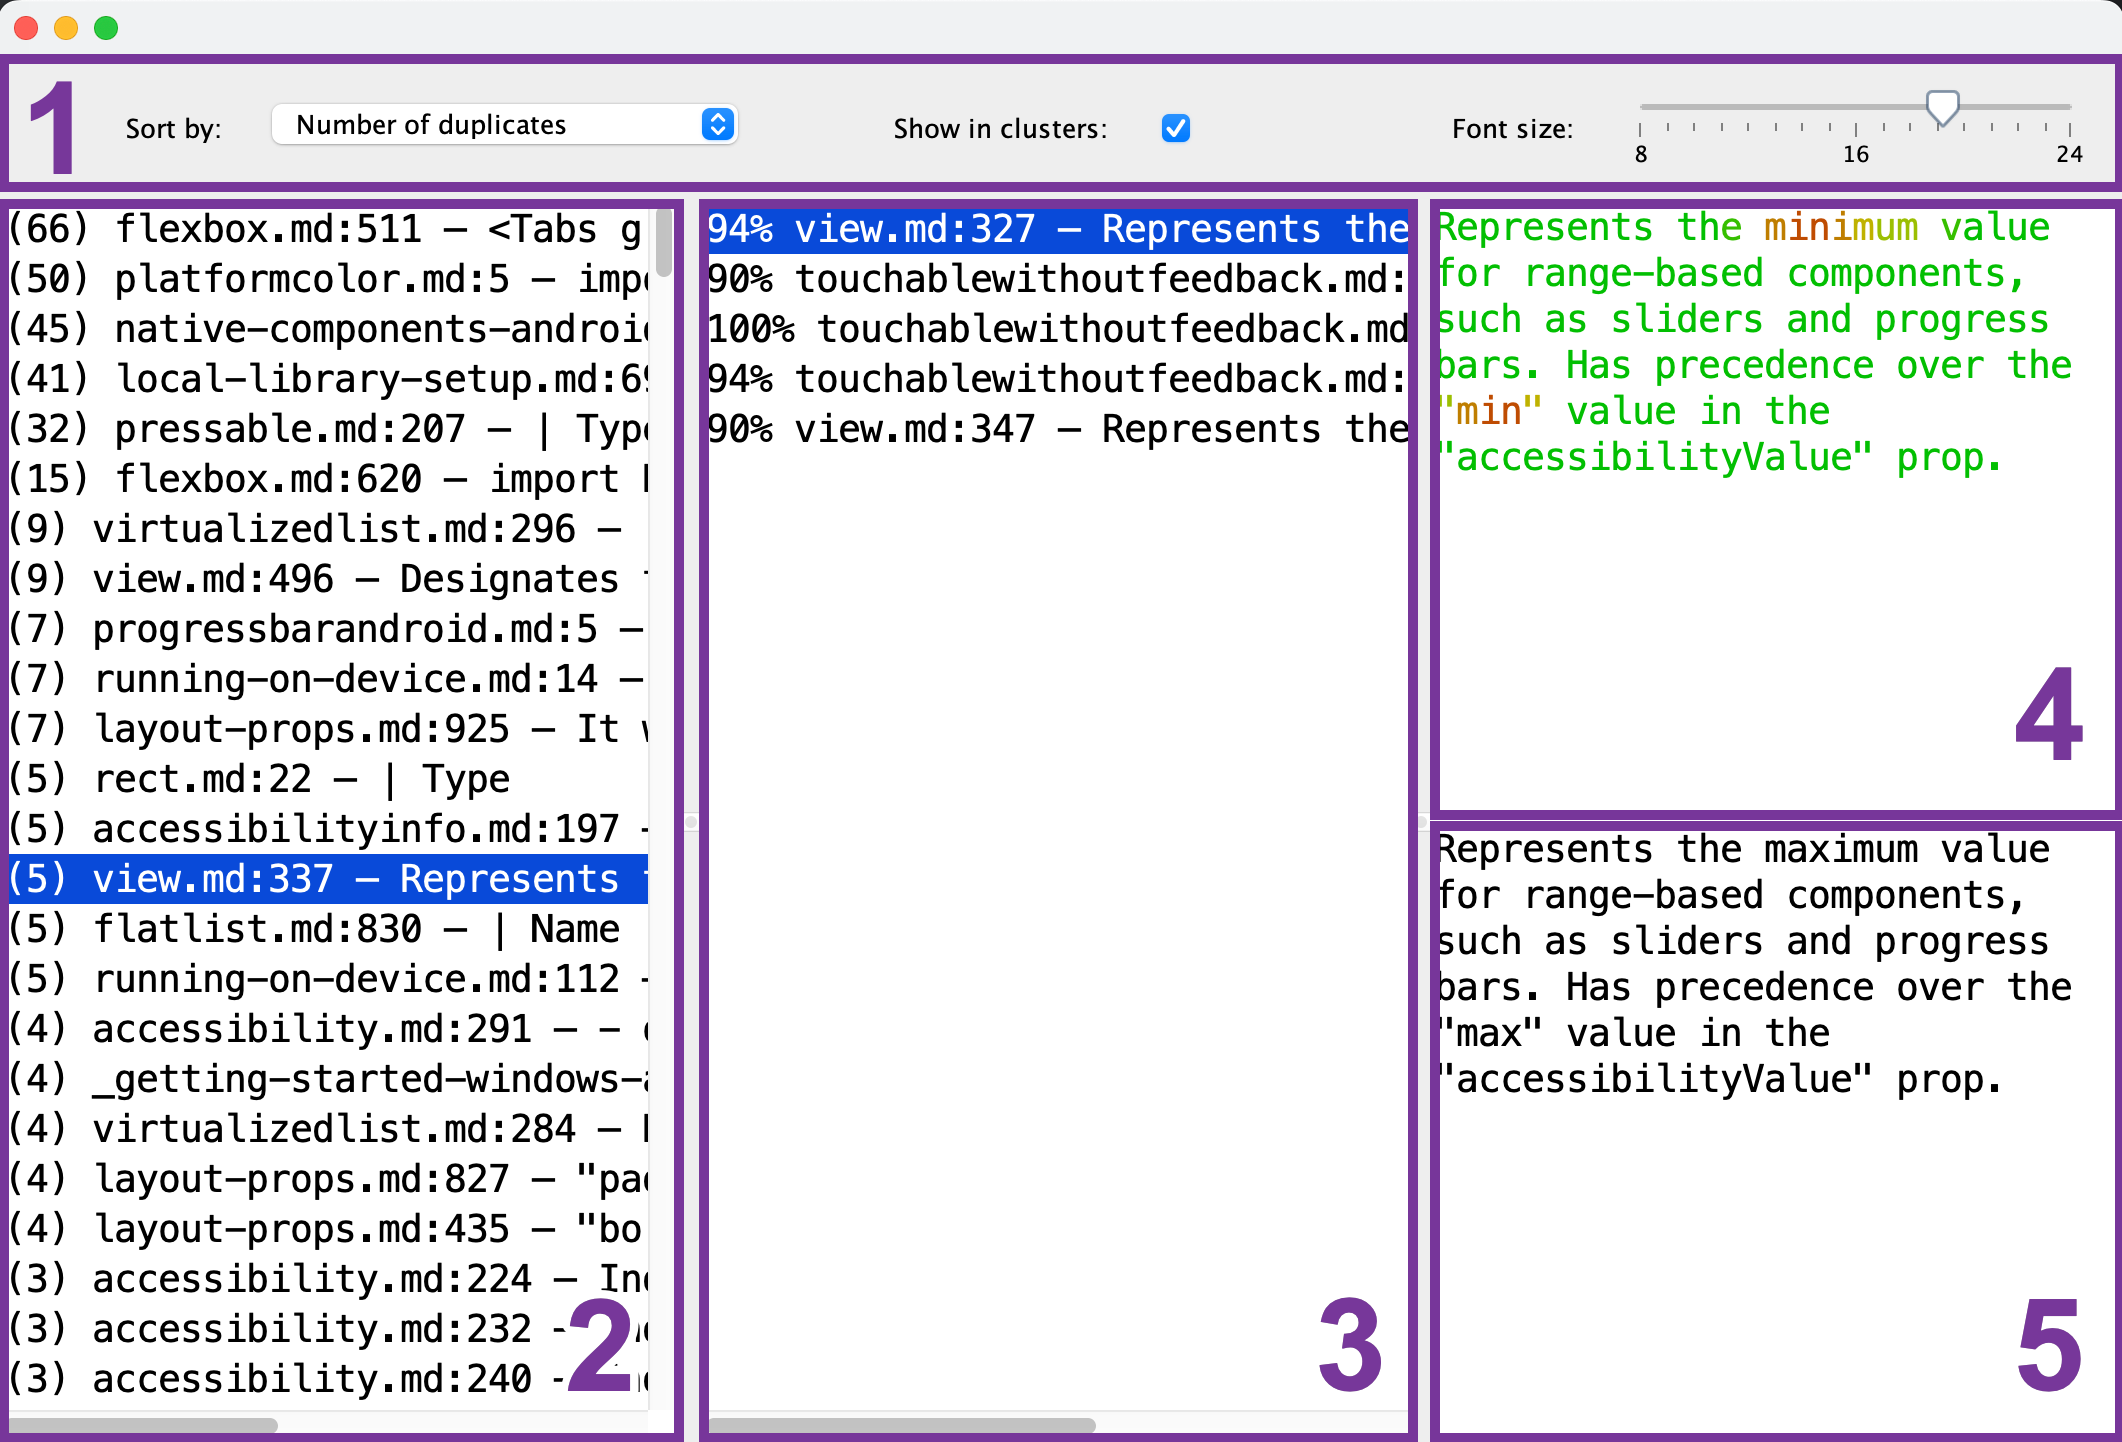
- 도구 모음: 글꼴 크기 설정, 정렬 순서, 각 중복 그룹에 대해 단일 참조 청크(2)만 볼지 여부를 구성합니다. Fuzzy search에서 검색할 텍스트를 입력하고 유사도 기준을 조절해 비슷한 구절을 찾을 수 있습니다.
- 참조 청크 목록: 비교를 위한 참조로 사용할 청크를 선택합니다.
- 중복 청크 목록: 참조 청크(2)를 선택한 후 이 목록은 유사한 청크를 표시합니다. 중복을 미리 보려면 목록에서 선택하십시오.
- 참조 청크 미리 보기: 참조 청크(2)를 선택한 후에는 내용 미리 보기가 가능합니다. 공통 부분은 녹색으로 표시되며, 다른 부분은 빨간색으로 표시됩니다. 더 많은 중복 청크(3)가 이 부분을 공유할수록 더 녹색이 나타납니다.
- 중복 청크 미리 보기: 중복 청크를 선택한 후 미리 보기가 여기에 나타납니다. 선택한 참조 청크(4)와의 빠른 비교에 사용할 수 있습니다.
자세히 알아보기 및 연락처
이 도구의 개발에 관심이 있다면 관련 블로그 시리즈를 확인하세요:
피드백이 있으면 이 페이지 하단의 연락처를 사용하여 연락하십시오. 귀하의 의견과 기능 요청을 듣고 싶습니다.
라이센스
코드는 MIT 라이센스하에 라이센스가 부여되며, 이는 귀하가 어떠한 목적에서도 이를 자유롭게 사용할 수 있음을 의미합니다. 포크 및 수정할 수 있습니다.


